تصور کنید سه متخصص را استخدام کردهاید تا کیفیت یک گزارش را ارزیابی کنند. یکی از آنها گزارش را خودش نوشته است. آیا میتوانید مطمئن باشید که ارزیابی او کاملاً بیطرفانه خواهد بود؟
حالا همین آزمایش را با مدلهای هوش مصنوعی انجام دهید. پاسخهای چند مدل را در اختیار یک مدل دیگر بگذارید، از آن بخواهید کیفیتشان را مقایسه کند و ببینید آیا به پاسخ خودش امتیاز بیشتری میدهد یا نه.
نتیجه همیشه یکسان نیست؛ اما همین تفاوتها پرسشی مهم را مطرح میکنند: آیا مدلهای هوش مصنوعی گاهی به نفع خودشان قضاوت میکنند؟ و اگر چنین رفتاری مشاهده شود، آیا میتوان آن را «حسادت» نامید؟
برای پاسخدادن باید میان سه موضوع تفاوت بگذاریم: سوگیری در ارزیابی، ترجیح محتوای تولیدشده توسط خود مدل و احساسات انسانی. این سه مفهوم به یکدیگر شبیه به نظر میرسند، اما از نظر علمی یکسان نیستند.
وقتی مدل هوش مصنوعی داور و شرکتکننده همزمان است
در ارزیابی مدلهای هوش مصنوعی، گاهی از یک مدل برای قضاوت درباره پاسخهای تولیدشده توسط چند مدل دیگر استفاده میشود. این روش میتواند سریعتر و کمهزینهتر از ارزیابی انسانی باشد؛ اما یک مسئله مهم دارد: آیا داور، محتوای همه مدلها را با معیارهای یکسان ارزیابی میکند؟
پژوهشی با عنوان Beyond the Surface: Measuring Self-Preference in LLM Judgments که در کنفرانس EMNLP سال ۲۰۲۵ منتشر شد، به همین مسئله میپردازد.
پژوهشگران توضیح میدهند که اگر یک مدل به پاسخهای خودش امتیاز بیشتری بدهد، نمیتوان فوراً نتیجه گرفت که سوگیری وجود دارد. ممکن است پاسخهای آن واقعاً بهتر باشند. بنابراین، مقایسه ساده امتیازها برای اثبات خودترجیحی کافی نیست و باید کیفیت واقعی پاسخها نیز در نظر گرفته شود.
این نکته اساسی است: اگر مدل خودش را بهتر ارزیابی کند، ابتدا باید بفهمیم آیا واقعاً بهتر بوده یا معیار ارزیابی به نفع او عمل کرده است.
منبع: مقاله پژوهشی در ACL Anthology
آزمایش واقعی چه چیزی را نشان میدهد؟
در آوریل ۲۰۲۶، شرکت Hone Labs نتایج آزمایشی را منتشر کرد که در آن سه مدل مطرح، خروجیهای تولیدشده توسط خودشان و یک محصول رقیب را ارزیابی کردند.
در این آزمایش، محصول Hone Studio میانگین امتیاز ۹۴٫۱ را از سه ارزیاب مستقل دریافت کرد. امتیازهای ChatGPT، Claude و Gemini برای محصول خودشان نیز با یکدیگر تفاوت داشت.
| ارزیاب | میانگین امتیاز محصول خود |
|---|---|
| ChatGPT (GPT-5.5) | ۸۴٫۳ |
| Claude Opus 4.6 | ۸۱٫۸ |
| Gemini 3 Pro | ۷۵٫۲ |
| Hone Studio | ۹۴٫۱ |
اعداد جدول، امتیازهای گزارششده در بنچمارک Hone Labs هستند؛ نه نتیجه یک آزمایش مستقل و جامع درباره تمام مدلهای هوش مصنوعی.
این شرکت همچنین گزارش کرد که ChatGPT به خروجی خود امتیاز بیشتری از میانگین امتیازهای سایر ارزیابان داده است، درحالیکه Claude در ارزیابی خروجی خود امتیاز پایینتری ثبت کرده بود.
اما یک محدودیت مهم وجود دارد: Hone Labs متن کامل خروجیها و سند اصلی مورد ارزیابی را منتشر نکرده است. بنابراین، امکان بررسی مستقل تمام جزئیات آزمایش وجود ندارد.
این نتایج را باید یک نمونه قابلتوجه از رفتار ارزیابی مدلها دانست، نه اثبات قطعی اینکه تمام مدلها همواره از خودشان دفاع میکنند.
منبع: بنچمارک Hone Labs، منتشرشده در ۱۴ آوریل ۲۰۲۶
وقتی نام سازنده میتواند بر قضاوت اثر بگذارد
مسئله فقط کیفیت پاسخ نیست. گاهی هویت تولیدکننده نیز میتواند در ارزیابی نقش داشته باشد.
در یک مطالعه منتشرشده در مه ۲۰۲۶، چهار مدل Claude Opus 4.7، Gemini 3.1 Pro، GPT-5.5 و Kimi K2.6 پاسخهای یکدیگر را در چند وضعیت ارزیابی کردند. پژوهشگران علاوه بر بررسی خودترجیحی، اثر تغییر متن و نمایش برچسب هویت مدلها را نیز آزمایش کردند.
نتیجه جالب بود: هیچ الگوی واحدی از خودترجیحی در همه مدلها مشاهده نشد.
در دادههای گزارششده، Claude در برخی ارزیابیها به شباهت سبکی حساس بود، GPT-5.5 در برخی موارد با محتوایی که به باورهای خودش نزدیکتر بود همدلی بیشتری نشان میداد و اثر کلی برای Gemini تقریباً خنثی بود. نتایج Kimi نیز با عواملی از جمله تولید پاسخهای خارج از موضوع همراه بود.
این مطالعه همچنین نشان داد که تشخیص یا تصور هویت نویسنده میتواند با تغییر امتیاز ارتباط داشته باشد. بااینحال، اثر برچسب هویت برای تمام مدلها یکسان نبود و نتایج به شرایط آزمایش وابسته بودند.
از آنجا که این مطالعه در قالب یک پروژه آزمایشی منتشر شده است، باید آن را با احتیاط بیشتری نسبت به پژوهشهای داوریشده دانشگاهی تفسیر کرد.
منبع: Do AI judges play favorites?، مطالعه آزمایشی مه ۲۰۲۶
آیا هوش مصنوعی محصولات خودش را هم ترجیح میدهد؟
فرض کنید از یک دستیار هوش مصنوعی میخواهید بهترین ابزار تولید محتوا، نرمافزار تحلیل داده یا سرویس پردازش متن را معرفی کند. اگر یکی از گزینهها محصول شرکت سازنده همان دستیار باشد، آیا آن محصول بهطور طبیعی در صدر پیشنهادها قرار میگیرد؟
این پرسش از نظر تجاری اهمیت زیادی دارد؛ زیرا توصیههای هوش مصنوعی میتوانند بر تصمیم خرید کاربران تأثیر بگذارند.
برای پاسخ دقیق، باید چند احتمال را از یکدیگر جدا کنیم:
- محصول متعلق به سازنده مدل واقعاً با نیاز کاربر تناسب بیشتری دارد.
- اطلاعات آموزشی یا نحوه طراحی سیستم باعث شده است محصول خاصی بیشتر معرفی شود.
- مدل در شرایط مشابه، محصولات وابسته به سازنده خود را بهطور ناموجه ترجیح میدهد.
- نحوه صورتبندی سؤال یا اطلاعات ارائهشده به مدل، نتیجه را تغییر میدهد.
تنها مورد سوم مستقیماً به ادعای خودترجیحی ناموجه نزدیک میشود و برای اثبات آن به آزمایش کنترلشده نیاز داریم.
پژوهشهای مربوط به توصیه محصولات نشان میدهند که مدلهای زبانی میتوانند تحت تأثیر سوگیریهای مختلف قرار بگیرند. برای مثال، پژوهش Bias Beware: The Impact of Cognitive Biases on LLM-Driven Product Recommendations که در EMNLP 2025 منتشر شد، بررسی کرد که چگونه دستکاریهای مبتنی بر سوگیریهای شناختی میتوانند رتبه و احتمال توصیه محصولات را تغییر دهند.
این پژوهش بهتنهایی ثابت نمیکند که مدلها محصولات سازندگان خود را ترجیح میدهند؛ اما نشان میدهد که توصیههای تولیدشده توسط هوش مصنوعی لزوماً نتیجه مقایسهای خنثی و مستقل نیستند.
منبع: مقاله پژوهشی در ACL Anthology
سوگیری را میتوان آزمایش کرد؛ حسادت را نه به این سادگی
در اینجا باید مرز میان مشاهده و تفسیر را حفظ کنیم. اگر مدلی به پاسخ خودش امتیاز بیشتری بدهد، رفتاری قابلاندازهگیری مشاهده کردهایم. اگر با تغییر برچسب نویسنده، امتیاز پاسخ تغییر کند، میتوان اثر هویت ادراکشده را بررسی کرد. اگر محصولی را بدون توجیه کافی بالاتر از رقبا قرار دهد، میتوان احتمال سوگیری در توصیه را آزمود.
اما هیچیک از این مشاهدات بهتنهایی نشان نمیدهد که مدل احساس حسادت دارد.
حسادت در انسان با تجربههای ذهنی، هیجانها و انگیزههای روانشناختی مرتبط است. در مقابل، مشاهده یک الگوی رفتاری در خروجی مدل، بهخودیخود وجود چنین تجربهای را اثبات نمیکند.
ممکن است رفتار یک مدل از بیرون شبیه رقابت، دفاع از خود یا حتی حسادت به نظر برسد؛ اما شباهت رفتاری با اثبات تجربه درونی یکسان نیست.
به بیان ساده، میتوانیم بپرسیم «آیا مدل به نفع خودش قضاوت میکند؟» و برای پاسخ، آزمایش طراحی کنیم. اما تبدیل این نتیجه به ادعای «مدل حسود است» به شواهدی بسیار فراتر از امتیازها و توصیههای آن نیاز دارد.
برای انتخاب مدل مناسب چه باید کرد؟
برای کسبوکارها، پرسش اصلی این نیست که کدام مدل شخصیت بهتری دارد؛ مسئله این است که کدام مدل برای یک وظیفه مشخص، نتیجه قابلاعتمادتر و مناسبتری ارائه میکند.
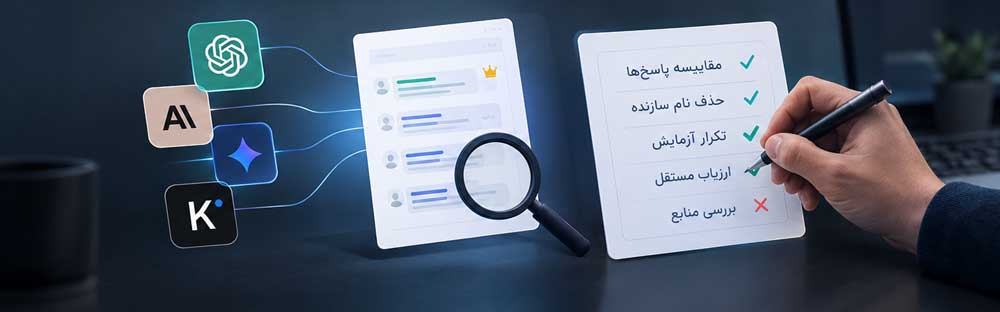
اگر قرار است از هوش مصنوعی برای انتخاب محصول، ارزیابی محتوا یا مقایسه ابزارهای تجاری استفاده کنید، چند اقدام عملی میتواند کیفیت تصمیمگیری را افزایش دهد:
| اقدام | هدف |
|---|---|
| تعریف معیارهای ارزیابی پیش از آزمایش | کاهش تغییر معیارها به نفع یک گزینه |
| حذف نام سازنده از پاسخها | بررسی اثر هویت و برچسب |
| مقایسه پاسخها با معیارهای یکسان | تفکیک کیفیت واقعی از ترجیح احتمالی |
| تکرار آزمایش با پرسشهای مختلف | شناسایی رفتارهای ناپایدار |
| استفاده از ارزیاب مستقل یا چند ارزیاب | کاهش وابستگی نتیجه به یک مدل |
| بررسی شواهد و منابع توصیهها | تشخیص پیشنهاد مستدل از ادعای بدون پشتوانه |
هیچکدام از این روشها بهتنهایی بیطرفی کامل را تضمین نمیکند. حتی مدلهای مختلف ممکن است سوگیریهای مشترکی داشته باشند. بااینحال، چنین رویکردی انتخاب مدل را از یک تصمیم مبتنی بر شهرت یا برداشت شخصی، به فرآیندی قابلآزمایش و قابلمقایسه تبدیل میکند.
جمعبندی: به رفتار مدل اعتماد کنید، نه به داستانی که درباره آن میسازیم
مدلهای هوش مصنوعی میتوانند در ارزیابی، رتبهبندی و توصیه محصولات رفتارهای جانبدارانه نشان دهند. پژوهشهای موجود نیز راههایی برای اندازهگیری این رفتارها پیشنهاد کردهاند. اما نتایج یکسان نیستند و تشخیص سوگیری به کنترل کیفیت پاسخها، شرایط آزمایش و اثر هویت نیاز دارد.
برای کسبوکارها، این موضوع یک پیام روشن دارد: مدل مناسب را با آزمون عملکرد آن انتخاب کنید، نه با این فرض که خروجیاش الزاماً بیطرفانه است.
و درباره حسادت؟ فعلاً میتوانیم شباهتهای رفتاری را بررسی کنیم، اما نباید از مشاهده سوگیری، وجود احساسات انسانی را نتیجه بگیریم.
شاید پرسش مهمتر از اینکه «آیا هوش مصنوعی حسادت میکند؟» این باشد: وقتی قرار است هوش مصنوعی به ما در تصمیمگیری کمک کند، چه سازوکاری داریم تا بفهمیم قضاوتش تا چه اندازه قابلاعتماد است؟